FOREDOOM / LAB RECORD 1516
大型ローカルLLMが動いた。それでも実務採用を見送った理由。
約58GBの大型ローカルLLMを既存Windows PCで実行し、Python・PHPのコード生成を検証。Pythonでは2,001件、複数条件のテストでは830件を全件クリアした一方、PHP修正には誤りが残りました。技術的な成功と実務での採用判断の違いを記録します。
Published
Pythonでは正確なコードを生成。一方、PHP修正では不合格だった実務適性の検証。
大型のAIモデルを自分のPCで動かせたとして、どこまで実際の仕事を任せられるのでしょうか。
foredoomでは、32GB RAMと16GB VRAMを備えたWindows PCで、本体約58GBのローカルLLMを動かす検証を行いました。
当初はメモリ不足に悩まされましたが、原因を調べて実行環境を調整し、限定された条件での推論に成功しています。
しかし、その先には別の問題がありました。
実際に生成された日本語の説明には不自然な部分があり、Web制作で使用するPHPの修正コードにも誤りが残っていたのです。
一方で、Pythonのコード生成テストでは、2,001件の入力ケースをすべてクリアするという結果も得られました。
さらに、複数の条件を組み合わせた別のPython課題でも、830件のテストケースに全件合格しています。
同じモデルでありながら、課題によって結果が大きく異なりました。
今回は、2026年11月2日から3日にかけて実施したコード生成能力の検証を通じて、ローカルLLMの可能性と、実際の仕事へ採用する際の判断について紹介します。
FIRST RESULTSモデルは動いた。でも回答は期待どおりではなかった
今回使用したのは、Qwen3.8-Flash-Nextを元にしたCoder派生モデルのIQ1_M版です。
実行にはStrataを使用しています。
このモデルは、元となる大型モデルからExpert数を削減し、強く量子化したものです。
モデル本体の容量は約58.4GBありますが、元の通常版と同じ性能や回答品質が維持されているとは限りません。
前回の検証では、このモデルを既存PCで動かすため、メモリ不足の原因調査と実行環境の改善に取り組みました。
その結果、短い質問に対する回答を最後まで生成できるようになっています。
ただし、最初の回答品質は期待したものではありませんでした。
日本語での説明には英語や中国語が混ざり、不自然な出力が見られました。
また、PHPのセキュリティ上の問題を修正する課題では、問題の種類を認識していながら、正確ではないコードを生成しています。
動作するという意味では技術的な成果がありましたが、そのまま仕事を任せられる状態とは言えません。
そこで次に、実行時の設定を調整することで回答を改善できないか、検証することにしました。
GENERATION SETTINGS設定を変えれば、回答は良くなるのか
AIの回答は、使用するモデルだけでなく、生成時の設定によっても変化することがあります。
まず試したのは、回答を出す前の推論処理を制御する「Reasoning Budget」の変更です。
設定値を512から128へ減らしたところ、推論を短く切り上げ、最終回答へ移る動作は確認できました。
しかし、肝心の回答品質は改善しませんでした。
日本語の説明では言語の混在や不自然な繰り返しが残り、PHPの回答では同じ言葉が大量に繰り返される問題も発生しています。
続いて、出力の繰り返しを抑える「Repetition Penalty」を1.1に設定しました。
こちらも今回の条件では、日本語やPHPの基本的な誤りを解消することはできませんでした。
| 試した設定 | 確認できた結果 |
|---|---|
| Reasoning Budget 512 → 128 | 最終回答への切り替えは成功。品質問題は残った |
| Repetition Penalty 1.1 | 不自然な出力や基本的な誤りは残った |
今回の検証は、それぞれ限定された単発の実行です。乱数のseedも固定していないため、設定の違いだけによって結果が変化したとは断定できません。
また、これらの設定が一般的に効果を持たないという意味でもありません。
ただ、今回のモデルと実行条件では、設定を調整するだけでは期待する品質を得られなかったという結果です。
そこで、同じ設定を繰り返し変更するのではなく、そもそもこのモデルは、どのような課題なら正しく処理できるのかを調べることにしました。
PYTHON CLAMPPythonでは2,001ケースをすべてクリアした
次に試したのは、比較的シンプルなPython関数の生成です。
整数を0〜100の範囲に収めるclamp_scoreという関数を作成させました。
例えば、150を入力すれば100、マイナスの数値を入力すれば0を返す処理です。
この課題は、Strataの公開検証記録でも使われていたもので、今回は英語と日本語の両方で指示を出しました。
まず英語で実行したところ、次のコードが生成されました。
def clamp_score(value: int) -> int:
    return max(0, min(100, value))
非常にシンプルですが、要求した動作を満たすコードです。
このコードを、事前に用意した2,001件の入力ケースでテストした結果、すべて合格しました。
さらに、同じ課題を日本語でも指示してみます。
すると、英語の場合とまったく同じコードが生成され、こちらも2,001件すべてのテストをクリアしました。
| 指示言語 | テスト結果 |
|---|---|
| 英語 | 2,001 / 2,001 PASS |
| 日本語 | 2,001 / 2,001 PASS |
最初の日本語説明では、英語や中国語が混ざる問題がありました。
それでも、日本語で伝えたPythonの仕様は正しく理解し、動作するコードへ反映できていたのです。
この結果から、少なくとも「自然な日本語で説明できないから、日本語の指示を理解できないモデルだ」という単純な評価は適切ではないと分かりました。
ただし、ここでいう2,001件の合格は、AIが2,001回コードを生成して成功したという意味ではありません。
英語と日本語でそれぞれ1回生成したコードを、2,001種類の入力ケースで検証した結果です。
繰り返し実行した場合の成功率や、Python全般の能力を示すものではありません。
それでも、最初の回答だけでは見えなかった可能性を確認できたことは、今回の研究における重要な成果でした。
PHP VALIDATIONPHPでは、正しい説明があっても不合格だった
Pythonで良好な結果が得られたため、最初に失敗していたPHPの修正問題も、条件を変えて再検証しました。
今回の課題は、Webサイトのセキュリティに関わるXSSへの対応です。
XSSとは、Webページへの文字列の出力方法などに問題がある場合、意図しないスクリプトが実行される可能性がある脆弱性です。
Web制作や運用を行うforedoomにとって、こうした修正コードの正確性は特に重要です。
今回は英語で指示を出し、生成時のtemperatureを0に設定して検証しました。
すると、AIはXSSの問題を正しく説明し、PHPのhtmlspecialcharsを使うという適切な修正方針を示しました。
ここまでは期待に近い回答です。
しかし、実際に提示されたコードを確認すると、最初の修正例にはPHPの構文として不正な部分が残っていました。
一方、2つ目の修正例は静的な確認では妥当と考えられる内容でした。
| 確認項目 | 結果 |
|---|---|
| XSSの問題説明 | 正確 |
| 修正方針 | 適切 |
| 1つ目の修正例 | 構文不正 |
| 2つ目の修正例 | 静的には妥当 |
| PHP CLIでの実行テスト | 未実施 |
| 最終判定 | FAIL |
この結果を、どう評価するべきでしょうか。
正しい説明があり、使える可能性のあるコードも含まれています。
それでも、今回の判定は不合格としました。
理由は、同じ回答の中に不正な修正コードが含まれていたからです。
実際のWebサイトでそのコードを採用すれば、正常な動作を損なう可能性があります。
特に既存サイトの改修では、コードの一部分だけでなく、周辺の仕様や他の処理への影響も確認しなければなりません。
今回の2つ目の修正例についても、PHP CLIで実際に動作を検証したわけではないため、正常に動くと保証できるものではありません。
また、この一度の結果だけで、モデルがPHP全般を不得意とすると判断することもできません。
今回の条件と課題では、回答全体を実務で採用できる品質とは判断しなかった、ということです。
一部に正しい回答があることと、その回答を安心して採用できることは違う。
Web制作の実務では、ここを曖昧にすることはできません。
COMPLEX PYTHONもう少し複雑なPythonでも、830ケースに合格
では、Pythonならどの程度まで正確なコードを生成できるのでしょうか。
最初のclamp_scoreは、比較的単純な処理でした。
そこで次に、複数の条件を組み合わせたforedoom独自の課題を用意しました。
生成させたのは、数値のリストを一定のルールに従って整形するnormalize_scoresという関数です。
今回は、単に数値を0〜100へ収めるだけではありません。
整数と小数を受け付ける一方で、真偽値や数値以外の入力は拒否する。NaNや無限大も受け付けず、Python標準のroundによる丸め方を使う。
さらに、入力された順序を維持し、元のリストを書き換えず、新しいリストを返すことも求めました。
ひとつひとつは基本的な条件ですが、すべてを同時に満たす必要があります。
今回も英語で指示を出し、コードを1回生成しました。
その結果、生成されたコードは事前に固定した830件のテストケースをすべてクリアしています。
830 / 830 PASS。生成コードの修正はありませんでした。
今回も830回の独立した生成に成功したという意味ではなく、1回の生成結果を830種類の入力条件で確認したものです。
また、あくまで今回設定した課題に対する評価であり、複雑なPythonプログラム全般を正確に生成できると証明したわけではありません。
それでも、複数の条件を含む課題でも、要求を満たすコードを生成できたことは確認できました。
最初に日本語やPHPの回答を見たときの印象だけでは、この結果は分からなかったと思います。
AIモデルの能力を評価するには、ひとつの回答だけでなく、何を任せたいのかに合わせて試すことが重要だと感じました。
WORK SUITABILITY仕事に使えるかどうかは、どう判断するのか
ここまでの検証結果を整理すると、次のようになります。
| 検証課題 | 判定 |
|---|---|
| Python clamp・英語指示 | SUCCESS |
| Python clamp・日本語指示 | SUCCESS |
| PHP XSS修正・英語指示 | FAIL |
| Python 複数条件関数・英語指示 | SUCCESS |
同じモデルでも、課題によって結果は大きく異なりました。
ただし、今回のPythonとPHPでは課題の内容や難度が違うため、これをそのまま言語別の性能比較として扱うことはできません。
今回の結果から分かったのは、モデルの大きさや、最初に生成された文章の印象だけでは、仕事への適性を判断できないということです。
そして、実務で使えるかを考えるうえでは、もうひとつ重要な視点があります。
それは、生成された結果を、どこまで確実に検証できるかということです。
例えば、今回のような小規模なPython関数であれば、入力と期待する結果を事前に定義し、生成されたコードを自動テストで確認できます。
もちろん、テストに合格したからといって、想定していないすべての条件でも正しく動くとは限りません。
それでも、合否を客観的に判断する手段を用意しやすい仕事です。
一方、Webサイトの改修では事情が異なります。
コードの構文が正しいだけでは十分ではありません。
既存の表示や動作を壊さないこと、セキュリティ上の問題を残さないこと、関連するページや機能へ影響を与えないことなど、確認すべき範囲が広がります。
AIが正しい方向性を示したとしても、修正内容を人が詳しく確認しなければならないのであれば、実際の作業負担がどれだけ減るかは分かりません。
つまり、AIの実務適性は、モデル単体の回答品質だけで決まるものではないのです。
生成したものを検証する仕組み、修正に必要な工数、問題が発生した場合の影響。
そうした要素まで含めて評価する必要があります。
今回の検証では、限定されたPython課題に可能性を感じる一方で、実務に組み込むには、まだ確認すべきことが多いと判断しました。
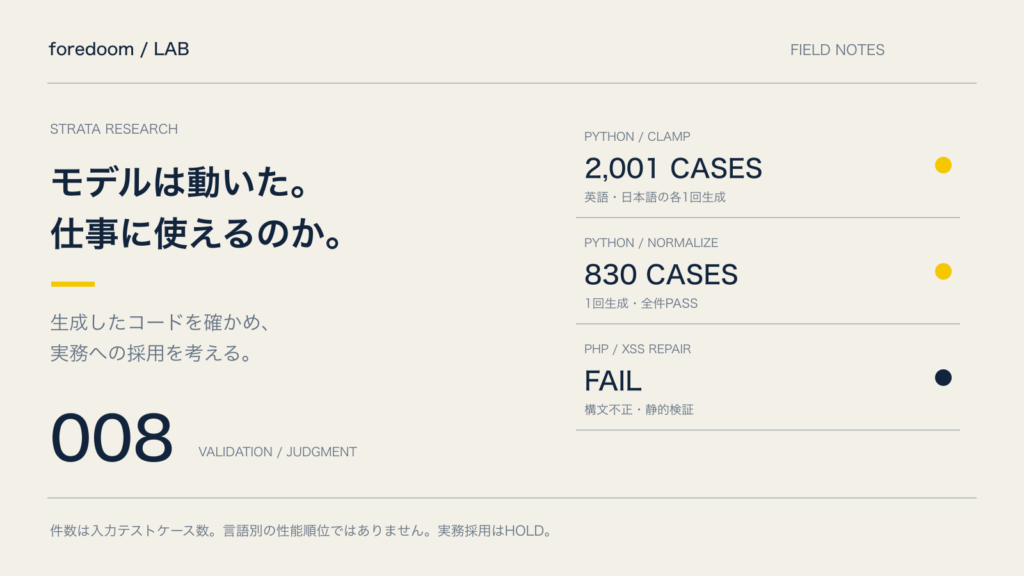
Python clamp / 英語
2,001 / 2,001 PASS
1回生成したコードを2,001入力で検証。
Python clamp / 日本語
2,001 / 2,001 PASS
1回生成。英語指示の生成コードと完全一致。
Python normalize_scores / 英語
830 / 830 PASS
1回生成したコードを830入力で検証。修正なし。
PHP XSS修正 / 英語
FAIL
最初の修正例に構文不正。2つ目は静的には妥当。PHP CLI実行は未実施。
ケース数は生成回数ではありません。PythonとPHPでは課題・難度が異なるため、言語別の性能順位や同一尺度の成功率を示す図ではありません。実務採用はHOLDです。
NEXT STEPS今回は採用しない。それでも研究を続ける理由
今回の研究では、約58GBの大型モデルを既存PCで動作させ、限定されたPython課題で正確なコードを生成できることを確認しました。
技術的にも、モデルの能力評価という点でも、得られた成果があります。
一方で、日本語の説明やPHP修正には問題が残りました。
また、今回のテストはいずれも限定された単発の実行です。
同じ課題を何度も与えたときの再現性や、長時間動かした場合の安定性、実際の仕事でどれだけ人の確認や修正が必要になるかについては、まだ十分に測定できていません。
そのため、今回のモデルを実務へ採用する判断は見送りました。
ただし、研究そのものが失敗だったとは考えていません。
最初は、既存のWindows PCで大型モデルを動かせるかという技術的な挑戦でした。
実際に動かすことで、メモリの制約や実行方法について新しい知見が得られました。
そして、回答品質を詳しく確認することで、最初の印象だけでは評価できない能力があることも分かりました。
一方で、正しい回答が部分的に得られても、それだけで安全に仕事を任せられるわけではないことも確認できています。
今後は、通常版モデルや異なる量子化方式との比較、同じ課題での繰り返し検証などを進めていく予定です。
WindowsのRAMを増設する方法もあれば、大容量のユニファイドメモリを備えたMacを活用する方法もあります。
しかし、機材を高性能にすること自体が目的ではありません。
大きなモデルを動かせても、最終的に仕事の品質や効率が改善しなければ、投資する意味は限られます。
これからは、クラウドAIとローカルAIをどのように使い分ければよいのか、どの仕事なら安心して任せられるのかを、実際の業務に近い条件で確かめていきたいと考えています。
その際には、生成速度やモデルの性能だけでなく、人による確認や修正、機材や運用にかかる費用まで含めて判断する必要があります。
動かせるAIを増やすことと、仕事に役立つAIを増やすことは、同じではありません。
今回得られた成功も失敗も、次にどのモデルを試し、どんな機材を選び、どの仕事を任せていくかを決めるための材料になります。
foredoomでは、技術的な可能性を追究することと、それを実際の仕事へ結びつけることの両方を、これからも大切にしていきます。
Experiment Record
| 研究対象 | Strata × Qwen3.8-Flash-Next Coder IQ1_M |
|---|---|
| 実施期間 | 2026年11月2日〜3日 |
| 目的 | 大型ローカルLLMのコード生成能力と、Web制作・開発業務への適性を検証する |
| 検証環境 |
|
| 対象モデル | ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-Coder-GGUF / IQ1_M |
| Status | COMPLETED |
| 確認できた結果 |
|
| 研究上の判断 |
|
| 継続課題 |
|
Update Log
- 2026年11月2日大型モデルの初回実行後、日本語説明・PHP修正の品質課題を確認
- 2026年11月2日〜3日Reasoning・Samplingの調整とPython clamp生成の検証を開始
- 2026年11月3日日本語clamp、英語PHP XSS修正、複数条件Python関数の検証を実施
- 2026年11月3日限定的なPython成功とPHP不合格を踏まえ、実務採用HOLDを判断