FOREDOOM / LAB RECORD 1487
同じAIモデルでも、実行環境によって結果は変わるのか。
foredoomでは、同じGemma 4 12Bを異なる実行構成で検証しました。LM Studioで発生した出力制御の問題と、独立したllama.cppへの構成変更後の結果を比較。AIモデルを実際の業務に活用するための評価方法と、実行環境の選択に関する判断を記録します。
Published
Gemma 4 12Bの検証で見えた、ローカルLLMの実行環境と出力制御の関係
AIモデルを評価するとき、一般的には性能や処理速度、回答の品質などに注目します。
しかし、モデルそのものに十分な能力があっても、実行する環境や設定によって期待する結果が得られない場合があります。
foredoomでは、ローカルLLMを将来の業務や知識管理に活用するため、複数のモデルを実際のデータで検証しています。その過程で、GoogleのGemma 4 12Bを試した際に、思わぬ問題が発生しました。
モデルの読み込みには成功しているのに、必要な形式の回答が返ってこないのです。
当初使用していたLM Studioでは、AIの推論過程を期待どおりに制御できず、最終的な回答が空になるケースがありました。
そこで、モデルは変更せず、実行環境と設定を見直すことに。結果として、予定していた検証を最後まで実行できるようになり、モデルの能力についても具体的な評価が可能になりました。
同じAIモデルでも、動かし方によって仕事への使いやすさは変わるのか。
2026年10月に行った検証から、実際に起きた問題と改善の経緯、今後のローカルAI運用に生かせる知見を整理します。
CONTEXTモデルの能力を確かめる前に、問題が見つかった
foredoomでは、過去のChatGPT会話や業務記録を、将来も活用できる知識として蓄積する「Knowledge Asset」の研究を進めています。
そのためには、AIが過去の会話から、実際に行われたことや最終的な判断を正しく取り出せるかを確かめる必要があります。
前回のLAB #003「AIは過去の会話から、事実を正しく読み取れるのか。」では、この課題について検証しました。
初期に試したQwen3 14Bでは、元の会話を参照できていても、質問と実施済みの事実を混同するなどの問題が確認されています。
そこで、別のモデルなら結果が改善するのかを調べるため、Gemma 4 12Bを新たな検証対象に加えました。
当時のローカルAI環境では、すでにLM Studioを使ってQwen3を実行できていたため、Gemmaも同じ環境から試すことにしました。
今回確認したかったのは、自由な文章を生成する能力だけではありません。
過去の会話から必要な情報を取り出し、プログラムで扱える決められた形式で返せるかどうか。その先には、抽出した情報を安全に蓄積し、次の業務へ活用する構想があります。
ところが、肝心の意味理解を評価する前に、回答の出力で問題が発生しました。
OUTPUT CONTROLモデルは動いている。それでも答えが返ってこない
今回使用したGemma 4 12B QAT Q4_0は、約6.98GBのモデルファイルです。
検証には、AMD Radeon RX 9070 XT(VRAM 16GB)を搭載した既存のWindows PCを使用しています。
LM Studioでは、32Kのコンテキスト長でモデルを正常に読み込めました。起動できない、GPUで処理できないといった問題ではありません。
しかし、指定した形式で回答を生成しようとすると、期待した結果が得られませんでした。
Gemmaには、最終的な回答とは別に、推論過程を生成する仕組みがあります。今回はこのThinkingと呼ばれる処理を無効にし、必要な情報をJSON形式で取得しようとしていました。
JSONとは、プログラムが情報を扱いやすいように、決まった構造でデータを記述する形式です。
ところが、当時の設定ではThinkingを無効にしようとしても推論過程が生成され、用意した出力枠の大部分を消費していました。その結果、短いJSONを求めたテストでも、最終的な回答が空になるケースがあったのです。
AI内部では処理が進んでいても、必要な結果を取得できなければ、その先のプログラムは動かせません。
通常のチャットなら多少の出力の違いを人が読み取れますが、業務システムへ組み込む場合は、指定した形式で結果を受け取れることも重要になります。
この時点では、Gemmaの意味理解が優れているのか、それとも不足しているのか、判断できる状態ではありませんでした。
また、原因がLM Studioそのものにあるとも限りません。推論の制御方法やモデルとの会話形式など、複数の条件が関係している可能性があります。
そこで、Gemma自体を不採用にする前に、実行構成を変えて確認することにしました。
RUNTIMEモデルはそのまま、実行環境を見直す
次に試したのは、LM Studioを経由せず、独立したllama.cppからGemmaを実行する方法です。
llama.cppは、PC上で言語モデルを動かすためのソフトウェアで、今回はAMDのGPUを利用できるVulkan対応版を使用しています。
モデルファイルは、それまでLM Studioで使用していたものと同じです。別のGemmaへ交換したり、量子化し直したりしたわけではありません。
一方、実行環境の変更に合わせて、推論過程の制御や、入力・出力の形式を指定する設定も見直しました。
すると、これまで取得できなかった最終回答が、必要なJSON形式で出力できるようになりました。
変更前後の結果を整理すると、次のようになります。
| 確認項目 | LM Studio環境 | 独立llama.cpp環境 |
|---|---|---|
| 使用モデル | Gemma 4 12B | 同じGemma 4 12B |
| モデルの読み込み | 成功 | 成功 |
| 推論過程の制御 | 期待どおりに動作せず | 意図した制御を確認 |
| 最終JSON出力 | 空になるケースあり | 出力成功 |
| 過去会話の検証 | 正式評価前で停止 | 最後まで完走 |
ただし、これは実行ソフトウェアだけを変更した、厳密な同条件比較ではありません。
実際には、回答の生成方法や出力形式の制御など、複数の設定を同時に変更しています。そのため、どの要素が決定的な改善につながったのかまでは特定できていません。
それでも、今回の検証から確実に言えることがあります。
同じモデルファイルであっても、実行環境と設定の組み合わせを変えることで、それまで実行できなかった処理を進められる場合があるということです。
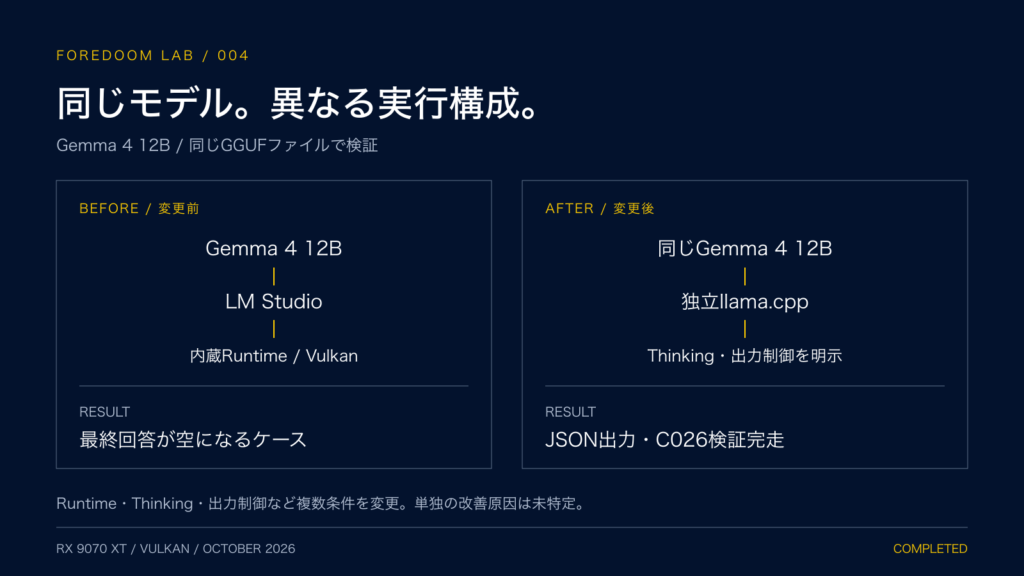
AIモデルは同じ。実行経路と制御条件を変更
BEFORE / 変更前
- Gemma 4 12B
- LM Studio
- 内蔵llama.cpp系Runtime / Vulkan
- RX 9070 XT
結果
最終回答が空になるケース
AFTER / 変更後
- 同じGemma 4 12B
- 独立llama.cpp
- Thinking / 出力制御の設定を明示
- Vulkan / RX 9070 XT
結果
JSON出力成功・C026検証完走
同じGGUFファイルを使用。Runtime・Thinking・出力制御など複数条件を変更しており、単独の改善原因は特定できていません。
EVALUATION正常に出力できるようになり、モデルの能力も評価できた
環境を変更したGemmaでは、推論過程を期待する形で制御できるようになり、JSONの出力も最後まで完了しました。
これによって、当初の目的だった過去会話の知識抽出テスト「C026」を実施できる状態になりました。
C026は、過去の会話に含まれる質問や提案、実際に行ったこと、最終的な判断などをAIが正しく区別できるかを評価する検証です。
Gemmaの結果は、主要な意味判断4項目すべてで良好でした。
質問を実施済みの事実として扱わず、暫定的な回避方法と根本的な解決も区別できています。確認していない効果を成功と断定することもなく、最終的に採用した運用方法を正しく保持できました。
技術的にも、49層すべてをGPUへ配置して動作させ、9件の参照IDが入力データ内に存在することを確認しています。
一方で、引用文を元の会話と一字一句同じ形で保持するという条件では、9件中2件が完全一致しませんでした。
意味の理解は良好だったものの、引用の表記や改行などに違いが残っていたためです。
そのため、確認済みの知識を完全自動で保存する用途については、今回も採用を見送っています。
ここで重要なのは、実行環境の変更によってすべての課題が解決したわけではないことです。
当初は出力の問題によってモデルの評価自体ができませんでした。しかし、環境を見直したことで検証を完了でき、Gemmaが得意とする部分と、まだ改善が必要な部分を具体的に把握できるようになりました。
モデルが動くこと、必要な形式で回答できること、実際の仕事に求められる品質を満たすこと。
これらは、それぞれ分けて評価する必要があります。
MODEL & TASKAIの評価は、モデル名だけでは決まらない
今回の経験から、foredoomではローカルLLMの評価方法を見直しています。
AIモデルを比較するとき、モデルの規模や生成速度、回答の正確さなどは重要な指標です。
しかし、今回のようにモデル自体は読み込めても、期待する形式で回答を取得できないことがあります。
その状態だけを見て性能不足と判断すれば、本来利用できる可能性のあったモデルを除外してしまうかもしれません。
実際の業務でAIを使うには、モデルの能力に加えて、それを動かす環境も適切である必要があります。
例えば、今回の検証で関係したのは、次のような要素です。
- モデル:どのAIを使用するか
- 実行環境:どのソフトウェアで動かすか
- 推論の制御:回答生成の過程をどう扱うか
- 入出力の設定:どのように質問を渡し、結果を受け取るか
技術的にはChat TemplateやGrammar、Samplingなども関係しますが、一般的な利用では、すべてを意識する必要はありません。
大切なのは、期待する結果が得られなかったとき、モデルそのものが原因なのか、実行環境や設定に課題があるのかを分けて考えることです。
また、文章作成では自然な回答ができても、過去の事実を正確に抽出する仕事では問題が残る場合もあります。
このためforedoomでは、文章作成や一般的な相談と、厳密な情報抽出を別々の評価対象として扱っています。
単純に優れたモデルを探すのではなく、どの構成で、何の仕事に、どこまで使えるのかを見極める方針です。
MODEL
使用するAI
RUNTIME
実行環境
CONTROL
推論・出力制御
TASK
実際に任せる仕事
どの構成で、何の仕事に、
どこまで使えるのか
モデルの能力だけでなく、実行構成と実際の仕事を組み合わせて評価します。
COST & VALUE改善できることと、改善する価値は別
今回、Gemmaの実行環境を見直したことには十分な意味がありました。
当初は必要な回答を取得できなかったモデルが、構成変更後には知識抽出の検証を最後まで実行でき、意味判断でも良好な結果を得られたためです。
さらに、その後は同じ独立llama.cppの環境を利用し、Macからブラウザ経由でGemmaを使える仕組みへも発展しています。
日本語での会話や長文作成など、日常的な用途にも使えることが確認できました。
ただし、すべてのモデルについて、動くまで実行環境を調整し続けることが合理的とは限りません。
モデルごとに専用の設定を用意し、問題が起きるたびにソフトウェアを変更して検証を繰り返せば、それだけ時間や手間がかかります。
本来、ローカルAIを導入する目的は、クラウドAIや人の作業負担を減らし、仕事の品質や効率を高めることです。
そのための準備に過剰な時間を費やしてしまえば、かえって目的から遠ざかってしまいます。
今回のGemmaでは環境を見直す価値がありましたが、すべてのモデルへ同じような調整を行うわけではありません。
技術的に改善できるかどうかだけでなく、改善に必要な手間と、そこから得られる実務上の価値を比較する。
これもローカルAIを業務へ取り入れるうえで、大切な判断基準だと考えています。
NEXT STEPS実際の仕事に適したAI環境を見つけていく
今回の検証では、同じAIモデルでも実行環境や設定の組み合わせによって、業務での評価が変わり得ることを確認しました。
その一方で、期待する形式で出力できるようになっても、すべての仕事を安心して任せられるわけではありません。
Gemmaは過去会話の意味を良好に読み取れましたが、確認済みの知識を完全自動で保存するには課題が残っています。
こうした結果を踏まえ、foredoomでは今後も、実行環境、出力の安定性、情報の正確性、導入にかかるコストを含めてローカルAIを評価していきます。
また、ローカルAIにクラウドAIと同じ役割をすべて担わせる必要もありません。
複雑な問題や新しい仕組みの設計にはクラウドAIを活用し、繰り返し発生する処理や文章の下書きなど、用途が整理された仕事からローカルAIの導入を検討しています。
検索やデータ変換のように、通常のプログラムで正確に処理できる仕事もあります。顧客対応や公開判断など、人が担うべき役割も変わりません。
foredoomが目指しているのは、これらを適切に組み合わせ、実際の仕事に役立つ仕組みをつくることです。
今回のGemmaの検証は、そのための判断材料をひとつ増やす取り組みになりました。
AIが期待どおりに動かないとき、モデルを変えるべきなのか、実行環境を見直すべきなのか。それとも、その仕事をAIに任せること自体を再検討すべきなのか。
今後もこうした判断を実際の検証に基づいて積み重ねながら、仕事の内容に合ったAIの活用方法を探っていきます。
Experiment Record
| 対象 | Gemma 4 12B QAT Q4_0の実行環境・出力制御検証 |
|---|---|
| 検証時期 | 2026年10月 |
| 目的 | 同じAIモデルを異なる実行構成で使用し、出力制御と業務評価への影響を確認する |
| 主な環境 | AMD Ryzen 7 9800X3D / Radeon RX 9070 XT 16GB / RAM 32GB / Windows 11 |
| 使用技術 | Gemma 4 12B QAT Q4_0、LM Studio、llama.cpp Vulkan b11838、Jinja、GBNF、Structured Output |
| Status | COMPLETED |
| 確認できた結果 |
|
| 継続課題 |
|
Update Log
- 2026年10月LM StudioでGemmaのモデル読み込みに成功。Thinking制御と最終回答の取得に問題を確認
- 2026年10月独立したllama.cpp環境へ構成変更。JSON出力とC026検証を完了