FOREDOOM / LAB RECORD 1498
ChatGPTの過去履歴は、どうすれば使える知識になるのか。
約2,700万文字のChatGPT会話履歴をPython・SQLite FTS5で検索可能にしました。検索DBの構築、記事候補5件・53メッセージの原文照合を通じて、過去の記録を探す仕組みと、正しい知識として活用するための課題を整理します。
Published
約2,700万文字の会話を検索可能にした、Python・SQLiteによる知識資産化の検証
ChatGPTを仕事に活用する中で、過去の会話は少しずつ増え続けています。
以前に解決したトラブル、試した技術、うまくいかなかった方法、そして最終的に選んだ判断。こうしたやり取りには、後から役立つ情報が数多く残されています。
しかし、必要になったときに、その情報を正確に探し出せるとは限りません。
foredoomでも、過去のChatGPT会話からブログ記事の題材を探す中で、同じ問題に直面しました。
ChatGPT上での探索でも多くの記事候補を見つけられましたが、古い会話まで網羅できているのか、最終的にどう解決したのか、正確な日時はいつだったのか。元の記録まで確認しようとすると、難しい部分が残っていました。
そこで、ChatGPTの会話履歴を手元に取り出し、必要な情報を検索できる仕組みを構築することにしました。
対象となったのは、約2,700万文字の会話データです。
当初はローカルLLMによる情報整理も想定していましたが、最初に実用的な成果が得られたのは、PythonとSQLiteによる通常の検索処理でした。
今回は、2026年10月に行った履歴データの取得から検索環境の構築、実際の検索検証までを紹介します。また、その経験を今後の知識資産化へどうつなげていくのかも整理します。
BACKGROUND過去の経験を、次の仕事に生かすために
foredoomでは、ChatGPTやCodexをWeb制作・運用、開発、業務自動化などに活用しています。
日々の会話には、完成した仕事の結果だけでなく、そこに至るまでの試行錯誤や判断の経緯も残されています。
以前と似た問題に直面したとき、過去に何を試し、なぜその方法を選んだのかが分かれば、同じ調査を繰り返す負担を減らせるかもしれません。
今回の直接的なきっかけは、ゲーム・シミュレーター関連メディア「Recordline」の記事候補探しでした。
過去のChatGPT会話から、実際に経験したトラブルや機材の検証結果を発掘し、記事として整理する取り組みです。
しかし、ひとつのトラブルについて何度も相談していると、途中で提案された方法と、最終的に採用した方法が異なることもあります。
正確な記事を書くためには、当時のやり取りをたどり、実際に何が起きたのかを確かめなければなりません。
この課題は、foredoomが研究している「Knowledge Asset」にもつながります。
Knowledge Assetとは、過去の経験や仕事の記録を、将来も活用できる知識として扱う考え方です。
ただし、すべての会話をAIに覚えさせれば実現するとは考えていません。
まず元の記録を保持し、必要な情報を探せるようにする。そのうえで、AIによる意味の整理や、人による確認を加えていく。
今回の実験は、その最初の土台づくりです。
SOURCE DATA取り出した会話履歴は、約2,700万文字
2026年10月20日、ChatGPTから取得した履歴データの調査を始めました。
対象となったのは、2024年8月29日から2026年10月18日までの会話です。
| 項目 | 確認できた規模 |
|---|---|
| 会話数 | 376 |
| 総メッセージ数 | 67,491 |
| 通常テキスト | 27,014,428文字 |
| 会話データ | JSONファイル4分割 |
| 添付ファイル実体 | 2,759件 |
この規模になると、必要な情報がどこにあるのか分からないまま、すべてをAIに読ませて整理する方法は効率的とは限りません。
また、データの取得自体にも問題がありました。
最初に取得したZIPファイルに欠損が見つかり、改めて取得した2回目のファイルも完全な状態ではなかったのです。
一方、今回の検索に必要な会話データのJSONファイルは正常に読み取ることができ、2回の取得内容も一致していました。
そこで、添付ファイルを含むすべてのデータを完全に復旧することにはこだわらず、利用可能と確認できた会話本文から検索環境を構築する方針を採りました。
今回の検索データベースは、主に会話のテキストを対象としています。画像やPDFなど、添付ファイルの内容まで完全に検索できるわけではありません。
利用できるデータと、まだ確認できていないデータを分けたうえで、まず実用的な仕組みを作る。
この判断によって、検索環境の構築へ進めることができました。
SEARCH FOUNDATION最初に必要だったのは、AIではなく検索の仕組み
約2,700万文字の会話を活用するために、何から始めるべきなのか。
検討した結果、最初に必要だったのは、会話全体をAIに理解させることではありませんでした。
どの会話に何が書かれているのか、必要なときに確実に探せること。
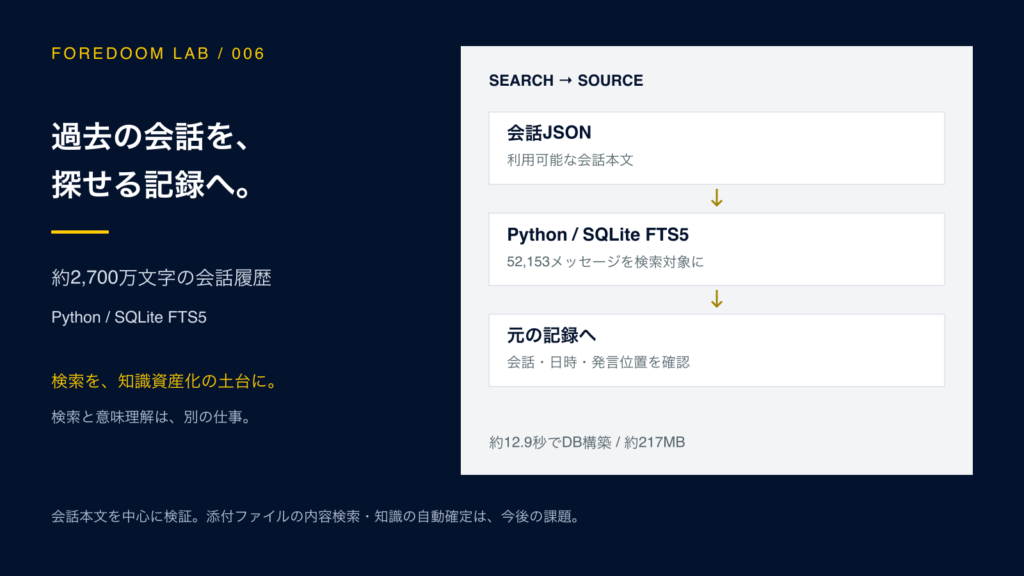
そこで、PythonとSQLiteを使った全文検索データベースを構築しました。
SQLiteは、データを保存・検索するための軽量なデータベースです。今回は全文検索機能のFTS5を利用し、日本語の部分一致検索にも対応できるようにしています。
この処理にローカルLLMは使用していません。
普段のWeb制作に使っているMacBook Pro上で、通常のプログラムとして実行しました。
また、単に検索結果を表示するだけではなく、元の会話へ戻れることも重視しています。
検索した文章がどの会話に含まれ、いつ発言されたのか。元のJSONファイルのどこに保存されているのか。そうした情報も一緒に管理する構成です。
さらに、ChatGPTには回答の再生成や編集によって、ひとつの会話が複数の経路に分かれる場合があります。
今回のデータでも、現在の会話につながる経路と、それ以外の分岐を区別して保存しました。
検索対象として登録した52,153メッセージの内訳は、現在経路が50,876件、それ以外の分岐が1,277件です。
これにより、単に過去の発言を見つけるだけでなく、その発言がどの会話の流れに属するのかも確認できます。
AIによる解釈を加える前に、元の記録を正しくたどれる状態を作ることを優先しました。
-
01 / SOURCE
会話JSON
利用可能と確認できた会話本文を使う
-
02 / INDEX
Python・SQLite FTS5
52,153メッセージを検索対象として登録
-
03 / SEARCH
キーワードで検索
日本語の部分一致にも対応
-
04 / EVIDENCE
元の記録を確認
会話・日時・発言位置・会話の経路をたどる
検索処理にローカルLLMは使用していません。今回の検索対象は主に会話本文であり、画像・PDFなど添付ファイルの内容を完全に検索する仕組みではありません。
MEASUREMENTS約12.9秒でDB化。検索は数ミリ秒だった
実際に検索データベースを構築したところ、想定していた以上に軽快に動作しました。
今回のMac環境では、約2,700万文字の会話データを対象とした検索DBを、約12.9秒で構築できています。
| 項目 | 実測結果 |
|---|---|
| DB登録メッセージ数 | 52,153 |
| 検索対象文字数 | 27,010,096文字 |
| データベース容量 | 約217MB |
| 構築時間 | 約12.9秒 |
Export全体の67,491メッセージが、すべて全文検索の対象になっているわけではありません。
通常の会話本文を中心に登録し、内部推論に関する情報や、検索対象としないデータは分けています。
検索速度についても、代表的な3つの検索語をそれぞれ10回実行し、中央値を計測しました。
| 検索語 | 検索時間の中央値 |
|---|---|
| recordline.net | 3.05ms |
| 記事候補 | 5.77ms |
| Recordline | 8.17ms |
いずれも数ミリ秒という結果です。
もちろん、この数値は今回のMacとデータベースで得られたものです。検索内容やデータ量、実行環境によって結果は変わります。
それでも、過去の会話から必要な情報を探す仕組みとしては、十分に実用的な速度でした。
ここで重要なのは、AIとの性能比較ではありません。
会話の場所を探すという仕事に対して、通常の検索プログラムで必要な結果が得られたことです。
高度なAIを使う前に、もっと単純な仕組みで解決できる部分があることを確認できました。
TRACEABILITY本当に必要な会話を見つけられるのか
検索DBが完成しても、実際に必要な記録を探せなければ意味がありません。
そこで、Recordlineの記事候補5件を使い、元の会話へたどり着けるか検証しました。
対象は、過去のChatGPT会話に元のやり取りが存在すると考えられていた記事候補です。
結果として、5件すべての元会話を発見できました。
さらに、対象となった合計53メッセージを元のJSONデータと照合し、内容が一致していることも確認しています。
| 検証項目 | 結果 |
|---|---|
| 対象記事候補 | 5件 |
| 元会話の発見 | 5/5件 |
| 対象メッセージ | 53件 |
| 元JSONとの一致確認 | 53/53件 |
※53件は5候補全体の合計です。
この検証によって、必要な会話の場所を特定し、AIによる要約ではなく、実際の発言へ戻れることが確認できました。
日時や会話の分岐も保持しているため、記事に必要な情報を原文から確認するための基盤として活用できます。
ただし、今回検証したのは、あらかじめ元の会話が存在すると考えられていた5件です。すべての話題を漏れなく検索できると証明したわけではありません。
また、ChatGPT上での探索と作業時間を同じ条件で比較したものでもありません。
今回の成果は、過去の記録を確実に探し、その内容を確認できる手段ができたことにあります。
SEARCH & UNDERSTANDING会話を探せることと、正しい知識にできることは違う
検索DBによって、必要な会話を見つけ、元の発言へ戻れるようになりました。
しかし、これだけでKnowledge Assetが完成するわけではありません。
例えば、過去の会話に「電源タップのスイッチを毎回切るようにした」という発言が残っていたとします。
検索すれば、その文章を見つけることはできます。
一方、それが途中で提案された方法なのか、実際に行ったことなのか。一時的な回避策なのか、根本的に解決した結果なのか。
文字列を検索するだけでは、こうした意味の違いまでは判断できません。
そこで次に取り組んだのが、ローカルLLMを使った知識の抽出です。
検索した会話から、実際に行ったことや最終的な判断を取り出し、将来も使える知識として整理できないか。
この検証は、後に「C026」と呼ぶテストへ発展しました。
ところが、実際にAIへ読み取らせると、元の発言を正しく参照していても、その意味を誤って解釈する問題が見つかりました。
この結果については、LAB #003「AIは過去の会話から、事実を正しく読み取れるのか。」で詳しく紹介しています。
今回のSQLiteによる検索DBが担うのは、過去の記録を見つけ、元の情報へ戻れるようにする部分です。
その記録から正しい事実や判断を取り出すには、別の検証が必要になります。
情報を探すことと、その意味を理解すること。
この2つを分けて考えることが、今回の研究で得られた重要な判断のひとつです。
今回実装・確認した範囲
検索 → 原文へ戻る
- Python・SQLiteで記録を探す
- 日時・発言位置・経路を確認する
- 5候補・計53メッセージを元JSONと照合
課題が残る範囲・今後の構想
意味の整理 → 知識の確定
- ローカルAIによる一次整理
- クラウドAIによる複雑な解釈
- 重要な事実の確定・判断は人が担う
C026では、元の発言を参照していても意味を誤る問題が確認されています。検索から知識の自動蓄積までが、すべて連携して動いているわけではありません。
NEXT STEPSAIに任せる前に、情報を扱う土台を整える
今回の実験を通じて、ChatGPTの過去履歴を検索できるようにするだけでも、実用的な成果が得られることが分かりました。
最初から大量の会話をAIへ渡すのではなく、まず通常のプログラムで必要な記録を探し、元の発言を確認できる状態にする。
そのうえで、意味の整理が必要な部分へAIを活用する。
この役割分担が、今回の目的には合っていました。
foredoomが将来目指すKnowledge Assetでは、ChatGPTの会話だけでなく、Web制作の作業履歴、メール、開発記録、各種資料なども活用する構想があります。
そこでは、利用するAIが変わっても、同じ記録を参照できることを重視しています。
例えば、過去の履歴を探す処理は通常のプログラムが担当し、抽出した内容の一次整理にはローカルAIを利用する。複雑な解釈にはクラウドAIを活用し、重要な事実の確定や判断は人が担う。
こうした役割分担が、今後の方向性として見えてきました。
もちろん、現時点ですべてが連携して動いているわけではありません。
今回実装できたのは、ChatGPTの会話本文を中心とした検索環境と、元の記録へ戻れる仕組みです。
そこから正しい知識を自動的に蓄積する方法や、複数のAIが同じ情報を利用する仕組みは、これからの研究課題になります。
一方で、今回の検証からは明確な成果が得られました。
過去の記録を活用するために、最初から高度なAIが必要とは限らない。
まず情報を失わず、必要なときに探せて、元の内容を確かめられること。
その土台があって初めて、AIによる知識の整理や活用も意味を持ちます。
今後も、通常のプログラムで確実に処理できる仕事と、AIによる理解が必要な仕事を分けながら、実際の業務に役立つKnowledge Assetの構築を進めていきます。
Experiment Record
| 対象 | ChatGPT Export履歴の検索DB構築・知識資産化検証 |
|---|---|
| 実施時期 | 2026年10月 |
| 目的 | 過去のChatGPT会話を検索可能にし、元の発言へ追跡できる情報基盤を構築する |
| 検証環境 | MacBook Pro M1 Pro / 16GB RAM |
| 使用技術 | Python / SQLite FTS5 / trigram全文検索 |
| Status | COMPLETED |
| 確認できた結果 |
|
| 継続課題 |
|
Update Log
- 2026年10月18日時点ChatGPT全履歴Exportを依頼済み
- 2026年10月20日Exportデータを取得。ZIPの欠損を確認し、再取得した会話JSONとの一致を検証
- 2026年10月20日Python・SQLite FTS5による検索DBを構築。Recordline候補5件で元会話の検索・照合を確認