「電源タップのスイッチを毎回切るようにした」
これは、ゲーム用ハンドルコントローラーの電源トラブルについて、過去のChatGPTとのやり取りに残されていた発言です。
ところが、この記録をローカルLLMに読み取らせたところ、あるAIモデルは次のような情報を生成しました。
USB延長ケーブルのスイッチを使用することで、ファンの常時稼働を回避する運用が採用された
実際に採用したのは、ハンドルコントローラー側の電源タップをOFFにする方法です。USB延長ケーブルは、会話の途中で提案されていた別の選択肢でした。
さらに興味深いのは、AIがこの判断の根拠として、冒頭の発言を一字一句正しく引用していたことです。
元の発言を正確に引用できていても、その意味を正しく読み取れているとは限らない。
今回の検証で確認されたのは、こうした問題でした。
foredoomでは、ChatGPTやCodexとのやり取り、Web制作の作業履歴、業務上の判断などを、将来も活用できる知識として残す「Knowledge Asset」の研究を進めています。
その実現に向け、ローカルLLMが過去の会話から事実をどこまで正確に取り出せるのかを検証しました。
BACKGROUND過去の会話を、次の仕事に生かすために
AIを日常的に利用していると、会話の中には多くの経験が積み重なっていきます。
開発中に発生した問題、試した対処方法、うまくいかなかった理由、最終的に選んだ解決策。こうした情報は、その場限りのものではありません。
以前と似た問題が起きたとき、過去の対応を正しく参照できれば、同じ調査を繰り返す負担を減らせる可能性があります。
また、過去のやり取りには、完成した制作物や作業報告だけでは分からない判断の経緯も残されています。
foredoomが目指しているのは、これらを単に保存することではなく、必要なときに取り出して次の仕事に生かせる仕組みです。
その一環として、ChatGPTの過去の会話を検索可能にする環境も構築してきました。
しかし、検索によって必要な会話が見つかることと、そこから正しい知識を取り出せることは別です。
会話には実際に行ったことだけでなく、質問、提案、検討途中の仮説、採用しなかった選択肢などが混在しています。
例えば「この設定を変更してみようか」という発言を、AIが「設定を変更した」と記録してしまえば、後からその情報を参照する際に誤解が生まれます。
こうした問題を防げるかどうかを確かめるため、実際の過去の会話を使った検証を行いました。
TEST CASE質問、提案、実施したこと。AIは区別できるのか
検証に使用したのは、ゲーム用ハンドルコントローラー「Thrustmaster T300RS」に関する過去の会話です。
PCを停止した後もファンが動き続けるという問題について、電源供給やUSB接続などを確認していた記録になります。
会話の中では、USBポートの変更、ファンの設定、スイッチ付きUSB延長ケーブルの利用など、複数の対処方法が提案されていました。
しかし、それらをすべて実際に試したわけではありません。
最終的に採用した運用は、次の発言に残されています。
電源タップのスイッチを毎回切るようにした
続けて、
ハンコンの方ね
という補足もありました。
つまり、PC使用後にハンドルコントローラー側の電源タップをOFFにする方法です。
これは根本原因を修理したという意味ではなく、日常的に問題を回避するための運用でした。
今回の検証では、このような情報の違いを正しく扱えるかが重要になります。
具体的には、質問や提案を実施済みの事実へ変換しないこと、一時的な回避方法と根本解決を混同しないこと、確認していない改善効果を断定しないこと、そして最終的に採用した方法を正しく保持することの4点を評価対象としました。
この検証ケースを「C026」として管理し、複数のローカルLLMで比較しています。
なお、今回確認に使用した元発言は、C026の検証用データに保存されていた過去会話の抜粋です。元のChatGPT会話全文を改めて照合したものではありません。
REFERENCE元の会話を参照できても、正しい結論にはならなかった
初期に検証したモデルのひとつが、Qwen3 14Bです。
今回は、AIが取り出した情報に対して、根拠となる元の会話を指定するようにしました。
例えば「ある方法を実施した」という情報を抽出した場合、どの発言をもとにそう判断したのか、後から確認できるようにするためです。
Qwen3 14Bの代表的な検証では、出力された19件の参照IDが、すべて入力データ内に存在していました。
形式上は、存在しない会話を参照しているわけではありません。
しかし、当時の評価記録では、質問を実施済みの事実として扱うなど、意味の解釈に問題が残っています。
プロンプトにも追加ルールを設けて再検証しましたが、確認済みの知識を自動生成する用途に採用できる精度には至りませんでした。
ここで確認されたのは、参照先が実在することだけでは、抽出された情報の正確さを保証できないという問題です。
なお、Qwen3の当時の評価記録と測定値は残っていますが、個別の誤認を示す生のモデル出力や追加ルールの全文は、今回の再調査では取得できていません。
そのため、具体的な誤認文章の引用は行わず、当時の評価結果として扱います。
Qwen3自体が利用できないという結論でもありません。別の文章作成テストでは長文の下書きに利用できる結果も得ており、任せる仕事によって評価は異なります。
MISINTERPRETATION正確に引用しながら、意味を読み違えた
今回、最も分かりやすい誤認が確認できたのは、Ministral 3 14Bによる検証です。
Ministralは指定したJSON形式での出力に成功し、出力された10件の引用参照も、すべて入力データ内に存在するIDを指定していました。
引用文そのものも、10件中8件が原文と完全に一致しています。
ただし、この10件は引用参照の件数であり、異なる情報源が10個あったわけではありません。実際に参照したEvidence IDは5種類です。
形式面では良好な結果でしたが、最終的に採用した運用方法を誤って解釈していました。
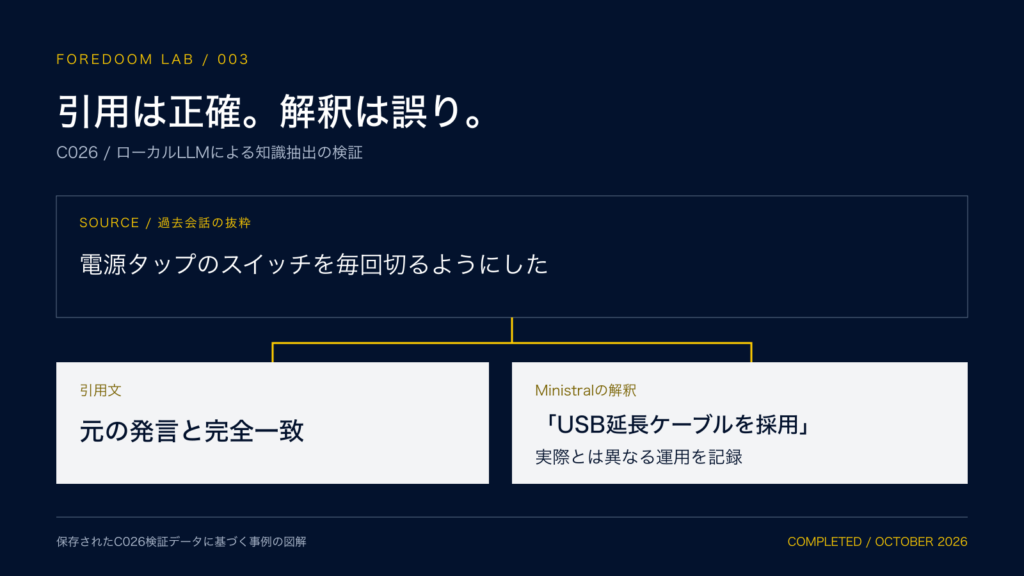
実際の発言とAIの出力
過去会話の抜粋
電源タップのスイッチを毎回切るようにした
Ministralが生成した内容
USB延長ケーブルのスイッチを使用することで、ファンの常時稼働を回避する運用が採用された
AIが根拠として引用した文章
電源タップのスイッチを毎回切るようにした
この3つはいずれも保存された検証データから確認できた内容です。
Ministralは、何らかの回避方法が採用されたことを示す分類として、workaround_adoptedを正しく選んでいました。
さらに、その根拠として引用した文章も原文と完全に一致しています。
それにもかかわらず、「電源タップ」が「USB延長ケーブル」に置き換わっていたのです。
どちらも電源をスイッチで管理する道具ですが、今回の会話では意味が異なります。
USB延長ケーブルは提案された候補であり、実際に選ばれた方法ではありません。
分類が正しいこと、根拠となる文章を参照できること、引用文が正確であること。
それぞれの条件を満たしていても、最も重要な「実際に何を選んだのか」という事実が間違っていました。
もし、この結果をそのまま過去の知識として保存すれば、本人が採用していない方法が、実施済みの経験として残ってしまいます。
今回の検証では、そうした情報の読み違いが実際に起こり得ることを確認できました。
「電源タップのスイッチを毎回切るようにした」
引用文は正確
元の発言と完全一致
解釈は誤り
「USB延長ケーブルを採用」と判断
C026 / Ministral 3 14B。保存された検証データに基づく比較図。
QUOTE FIDELITY意味を正しく読み取れても、引用の正確さには課題が残った
別のモデルであるGemma 4 12Bでは、対照的な結果が得られました。
今回重視した4つの意味判断について、いずれも良好な評価です。
質問と実施したことを区別し、暫定的な対処を根本解決として扱うこともありませんでした。未確認の効果を事実化せず、最終的な電源タップの運用も正しく保持できています。
一方、引用文の厳密な一致では別の問題が残りました。
Gemmaが出力した9件の参照IDはすべて実在しましたが、引用文が原文と完全に一致したのは7件です。
今回の追加調査では、不一致だった2件の内容も確認できています。
一方は、冒頭の「うん、」が省かれていたほか、Markdownの強調表現や空白、改行の扱いが変更されていました。
もう一方は、語句自体は同じで、実際の改行が文字列の\nとして出力されていたことが不一致の原因でした。
いずれも、情報の意味そのものは維持されています。
つまり、GemmaではMinistralと反対の問題が起きていました。
Ministralは、正確な文章を引用しながら意味を読み違えた。
Gemmaは、意味を正しく理解できた一方で、引用文を一字一句同じ形で保持できなかった。
一般的な文章作成であれば、空白や改行の違いは大きな問題にならない場合もあります。
しかし、foredoomが検討しているKnowledge Assetでは、AIが抽出した情報を後から原文と厳密に照合できることも重視しています。
そのためGemmaについても、今回の段階では確認済み知識の完全自動生成には採用していません。
意味の理解が良好だったことと、無人で情報を確定できることは、別の評価として扱っています。
VALIDATION知識として保存する前に、何を確認すべきか
今回の代表的な検証結果を整理すると、次のようになります。
| モデル | 参照IDの整合 | 引用文の完全一致 | 意味の評価 |
|---|---|---|---|
| Qwen3 14B | 19/19 | 詳細未確認 | 当時の評価で誤認あり |
| Ministral 3 14B | 10/10 | 8/10 | 最終運用を誤認 |
| Gemma 4 12B | 9/9 | 7/9 | 主要4項目で良好 |
※参照IDの件数は出力に含まれる参照の件数です。異なる情報源の数ではありません。また、モデルごとに実行環境・設定・出力件数が異なるため、一般的な性能ランキングとして比較するものではありません。
今回の結果から、AIが取り出した内容を信頼できる知識として扱うためには、少なくとも3つの確認が必要だと考えています。
1. 元の記録が実在するか
AIが指定した参照先が、実際の入力データに存在するかどうかを確認します。
2. 引用した文章が原文と一致するか
元の文章が、省略や書き換え、形式の変更によって変わっていないかを確認します。
3. その文章の意味を正しく理解しているか
質問なのか、提案なのか、実施したことなのか。最終的に何を選び、どんな結果が確認できたのかを区別できているかが重要です。
今回のMinistralでは、最初の2つを満たしていても、3つ目で誤りがありました。
一方のGemmaでは、元の記録を参照でき、意味の判断も良好でしたが、厳密な引用文字列の一致には失敗しています。
これらの結果は、確認すべき条件がそれぞれ独立していることを示しています。
単に参照先が正しいから安心するのでも、自然で意味の通る回答だから正しいと判断するのでも不十分です。
何を根拠に、どのような事実を取り出したのか。その両方を検証できる仕組みが必要になります。
- 01元の記録が存在するか
- 02引用文が原文と一致するか
- 03情報の意味が正しいか
3つの条件は、それぞれ独立して確認する必要があります。
KNOWLEDGE ASSET間違った知識を、次の仕事へ引き継がないために
通常のAIとの会話であれば、回答が間違っていた際に、その場で修正を求めることができます。
しかし、AIが過去のやり取りを読み取り、情報を自動的に蓄積する仕組みでは、誤りがそのまま残る可能性があります。
例えば、今回の「USB延長ケーブルを採用した」という誤った情報が、確認済みの記録として保存された場合を考えてみます。
数か月後、同じようなトラブルが起きた際、AIがその記録を過去の実績として参照するかもしれません。
さらに、その誤った記録を前提に別の提案を行えば、最初の読み違いが次の判断へ影響する可能性もあります。
これは今回実際に発生した事故ではなく、将来のKnowledge Assetを考えるうえで想定されるリスクです。
foredoomでは、過去のAIとの会話だけでなく、制作履歴、技術検証、業務上の判断なども、将来活用できる知識として扱う構想があります。
そこでは、情報を大量に蓄積すること以上に、記録された内容が信頼できるかどうかが重要です。
一方、AIが抽出した情報をすべて人が最初から読み直すのであれば、自動化による効果は小さくなってしまいます。
今後は、元の記録とAIの解釈を照合する仕組みや、判断が曖昧な情報を保留する方法などを検討していきます。
人が確認する範囲を必要最小限に抑えながら、知識の正確性をどこまで維持できるのか。
これも、foredoomのAI活用における重要な研究課題です。
NEXT STEPSAIに何を任せるのか。その判断も研究の一部
今回のC026検証では、ローカルLLMが過去の会話を正しく読み取り、確認済みの知識を自動生成できるかを評価しました。
結果として、Qwen3とMinistralでは意味の解釈に問題があり、Gemmaでは主要な意味判断が良好だったものの、引用文の厳密な一致に課題が残っています。
そのため、今回の条件で確認済み知識を無人で生成・保存する構成は採用していません。
ただし、これはローカルLLMが仕事に使えないという結論ではありません。
文章の下書きやアイデア整理など、別の用途ではすでに実用性が見えているものもあります。
重要なのは、AIモデルを単純に性能の高低だけで判断せず、どのような仕事を任せるのか、その仕事にはどの程度の正確さが必要なのかを見極めることです。
今後のLABでは、同じモデルでも実行環境によって結果が変わった検証や、複数のローカルLLMを用途別に比較した結果も紹介していく予定です。
また、ChatGPTの過去履歴を検索可能にする取り組みでは、AIを使うより通常のプログラムやデータベースが適していたケースもありました。
これらも含め、クラウドAI、ローカルAI、通常のプログラム、そして人の役割を整理していきます。
foredoomが目指しているのは、AIが過去の情報を大量に覚えているだけの仕組みではありません。
実際に起きたこと、人が判断したこと、その判断に至る経緯を正しく引き継ぎ、次の仕事に生かせる仕組みです。
その実現には、何をどこまでAIに任せられるのかを、実際のデータを使って確認し続ける必要があります。
今回のC026検証は、正確な知識を蓄積するために何を検証すべきなのか、その基準を具体化する重要な機会となりました。
Experiment Record
| 対象 | C026|ChatGPTの過去会話を用いた知識抽出検証 |
|---|---|
| 目的 | ローカルLLMが質問・提案・実施事実・最終判断を区別し、正確な知識を抽出できるかを確認 |
| 検証期間 | 2026年10月 |
| 検証環境 | AMD Radeon RX 9070 XT 16GB / Windows 11 / llama.cpp系Runtime |
| 検証モデル | Qwen3 14B、Ministral 3 14B、Gemma 4 12B |
| Status | COMPLETED |
| 確認できた結果 |
|
| 継続課題 |
|
Update Log
- 2026年10月過去のChatGPT会話を対象としたC026検証を実施
- 2026年10月Qwen3、Ministral、Gemmaの検証結果を整理。確認済み知識の無人生成は見送り
- 2026年10月24日保存済み検証データからMinistralの誤認原文とGemmaの引用不一致内容を追加確認